Ausgangslage
Die Serviceabteilung betreibt neben der zentralen IT eigene Fachanwendungen, unter anderem für Einsatzplanung, Dokumentation und Ersatzteilverwaltung. Diese liefen in einem eigenen Serverraum auf zwölf physischen Servern unterschiedlicher Generationen, verteilt auf vier Racks – in der Regel ein Server je Anwendung. Ein Teil der Hardware hatte das Ende des Herstellersupports erreicht, und eine zentrale Überwachung gab es nicht. Störungen fielen erst auf, wenn eine Anwendung nicht mehr erreichbar war.
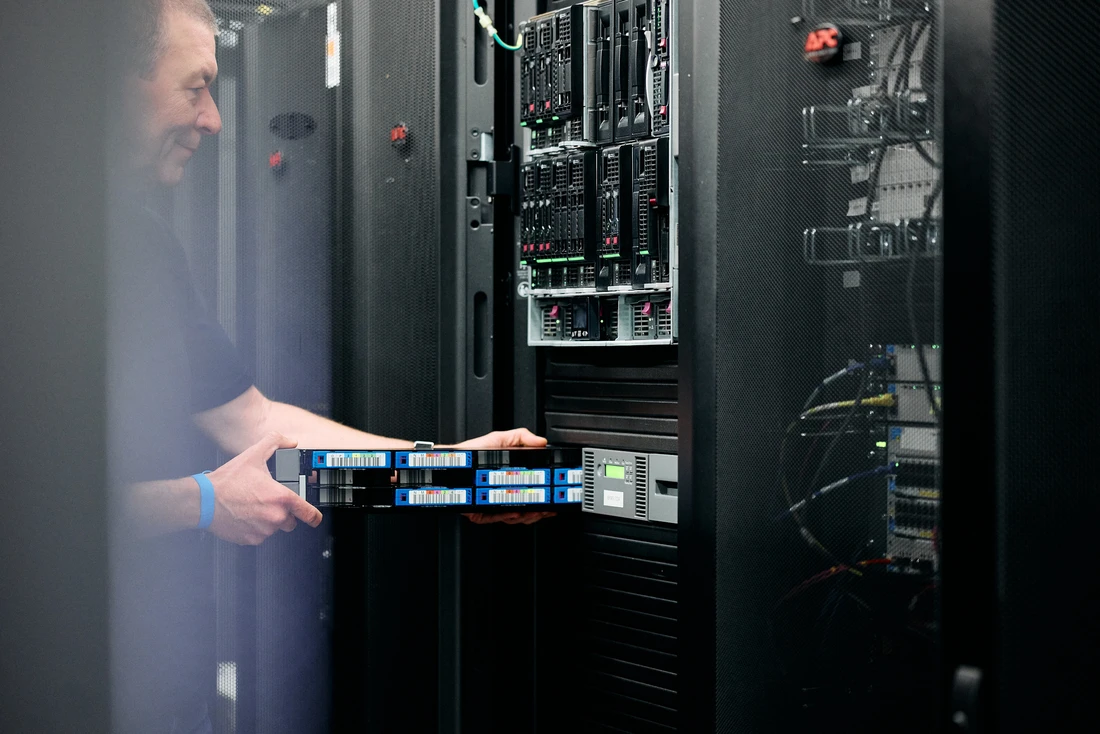
Gesichert wurde auf Band, die Medien wurden wöchentlich manuell gewechselt. Wiederherstellungstests fanden nicht statt. Offen war damit, ob und in welcher Zeit sich die Systeme im Schadensfall wiederherstellen ließen.
Ziele
- Hochverfügbarer Betrieb der Fachanwendungen ohne Abhängigkeit von einzelnen Servern
- Konsolidierung der Hardware, geringerer Energie- und Wartungsaufwand
- Ein Sicherungskonzept mit definierten Wiederherstellungszeiten und regelmäßigen Tests
- Proaktive Überwachung statt Fehlerbehebung nach dem Ausfall
- Kapazitätsreserven für die nächsten fünf Jahre
- Einbindung in die Vorgaben und Systeme der zentralen IT
Lösung
Wir haben die Anwendungen der Abteilung auf eine virtualisierte, hochverfügbare Plattform konsolidiert:
- Failover-Cluster mit drei Knoten: Alle Anwendungen laufen als virtuelle Maschinen auf drei HPE-ProLiant-Hosts mit Hyper-V. Fällt ein Host aus, starten die betroffenen VMs automatisch auf den verbleibenden Knoten neu. Wartungsarbeiten an einem Host sind im laufenden Betrieb möglich.
- Zentraler Speicher: Ein HPE-MSA-Speichersystem mit redundanten Controllern stellt den gemeinsamen Speicher für den Cluster bereit, ausgelegt auf das erwartete Datenwachstum der nächsten fünf Jahre.
- Datensicherung nach der 3-2-1-Regel: Veeam sichert alle VMs täglich auf ein separates Repository mit unveränderbaren Sicherungen und kopiert sie zusätzlich in das Rechenzentrum der zentralen IT. Einmal im Monat startet eine automatisierte Wiederherstellung die Systeme in einer isolierten Umgebung und prüft, ob sie lauffähig sind.
- Unterbrechungsfreie Stromversorgung: Eine neue USV überbrückt kurze Stromausfälle und fährt Cluster und Speichersystem bei längeren Ausfällen kontrolliert herunter.
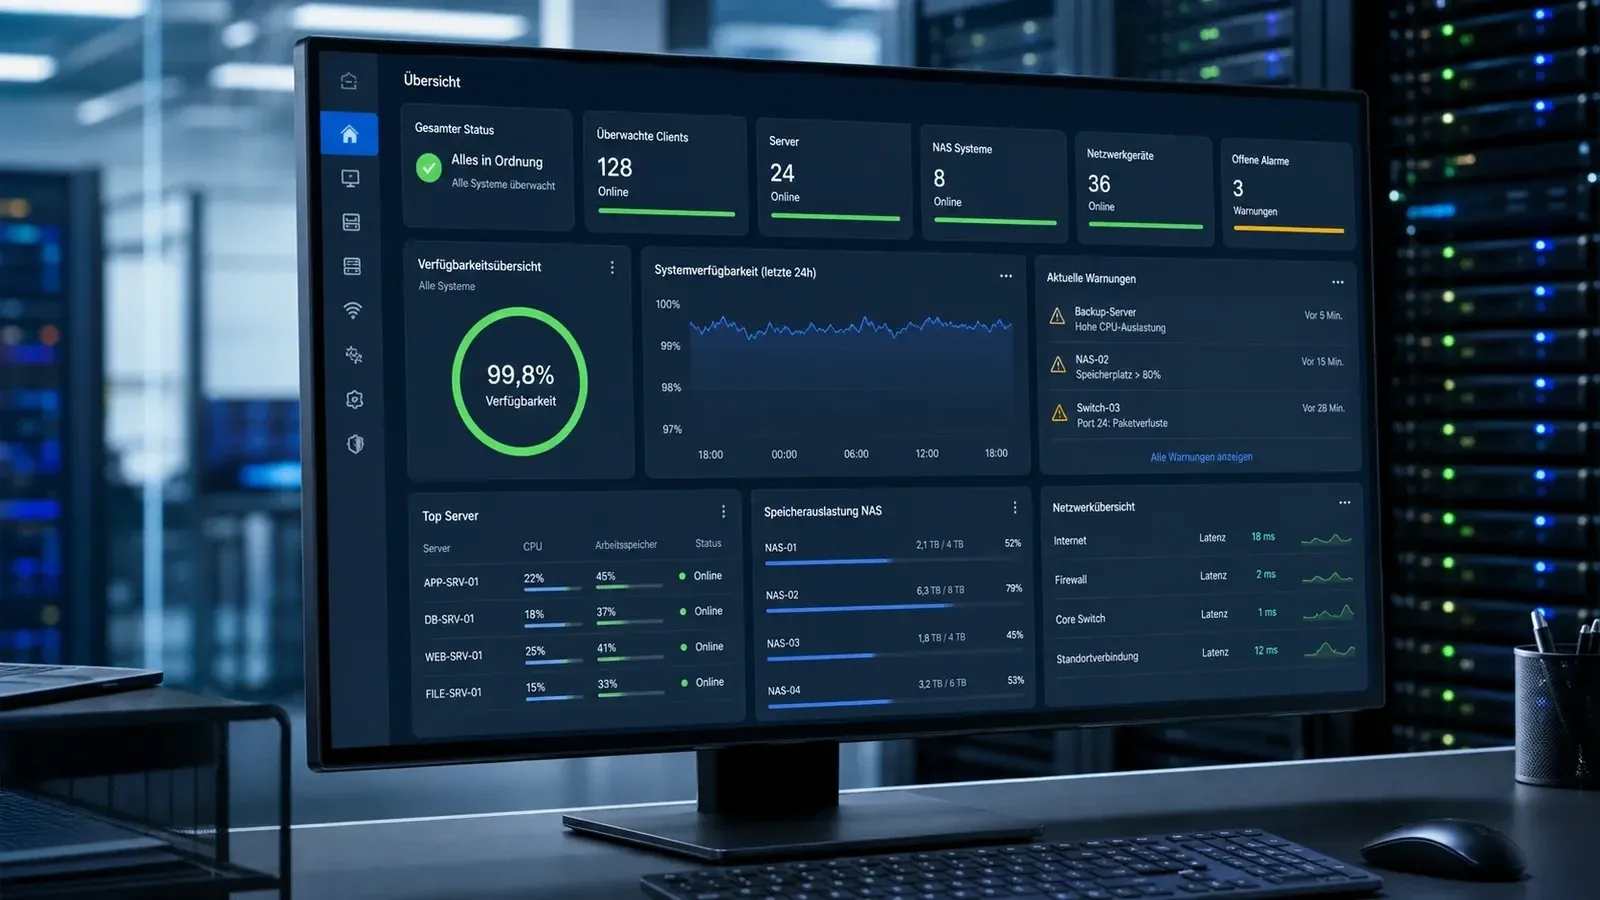
- Monitoring: Hardwarezustand, Speicherauslastung, Temperatur, Dienste und Sicherungsjobs werden zentral überwacht. Warnungen gehen an unser Betriebsteam, sodass wir eingreifen können, bevor es zu einem Ausfall kommt.
- Integration: Anbindung an das Active Directory, Netzsegmentierung und Firewall-Regeln haben wir nach den Vorgaben der zentralen IT umgesetzt.
Vorgehen
Am Anfang stand eine Bestandsaufnahme aller Server, Anwendungen und Abhängigkeiten. Daraus haben wir Kapazitätsplanung, Zielarchitektur und Migrationsplan abgeleitet und mit der Abteilung sowie der zentralen IT abgestimmt.
Die neue Plattform haben wir parallel zur bestehenden Umgebung aufgebaut und getestet. Anschließend wurden die Anwendungen schrittweise migriert – in abgestimmten Wartungsfenstern außerhalb der Betriebszeiten und jeweils mit definiertem Rückfallplan. Der Betrieb der Abteilung lief dabei ohne Unterbrechung weiter.
Nach Abschluss der Migration und einem erfolgreichen Wiederherstellungstest haben wir die Altsysteme außer Betrieb genommen, die Datenträger zertifiziert gelöscht und die Hardware fachgerecht entsorgt.
Ergebnis
Ein Cluster aus drei Hosts ersetzt die zwölf Einzelserver. Statt vier Racks wird nur noch eines benötigt, und der Stromverbrauch ist um rund 60 Prozent gesunken. Seit der Umstellung liegt die Verfügbarkeit der Fachanwendungen bei über 99,9 Prozent. Der Ausfall eines einzelnen Hosts hat keine Auswirkungen mehr auf die Verfügbarkeit der Anwendungen. Die Datensicherung wird jeden Monat nachweislich geprüft, die Wiederherstellungszeiten sind dokumentiert.
Betrieb und Weiterentwicklung
Im Rahmen eines Wartungsvertrags übernehmen wir Patch- und Firmware-Management, die Überwachung der Plattform und die Reaktion auf Störungen. Als nächster Schritt ist die Modernisierung von Netzwerk und WLAN in der Werkstatt geplant.